
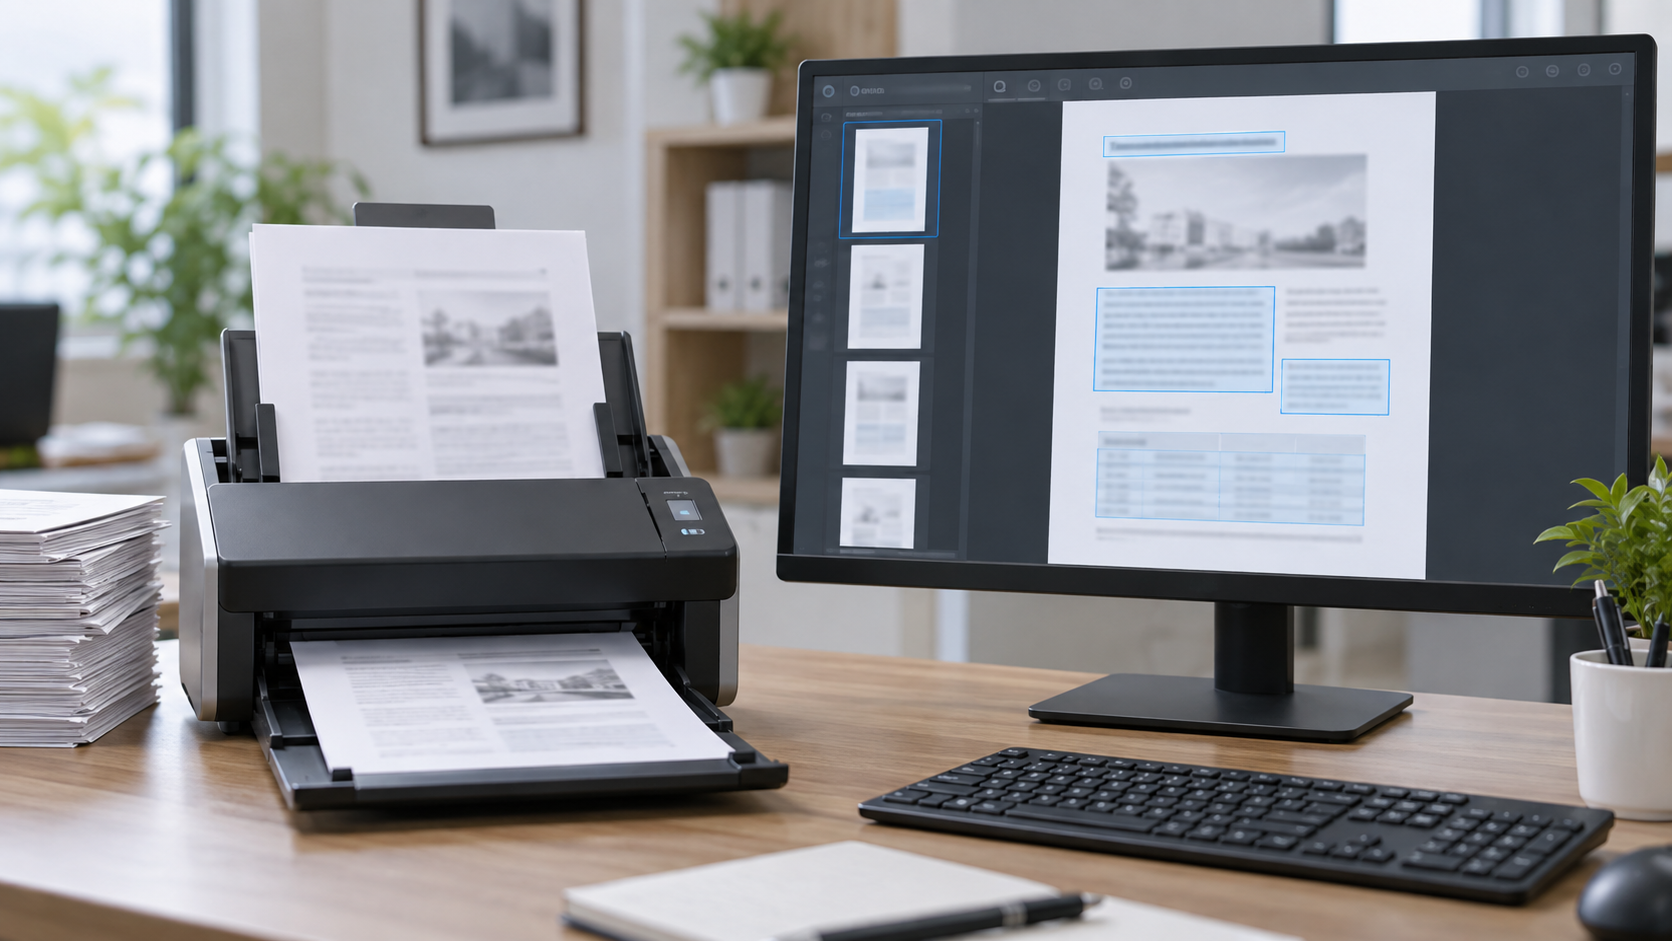
تفتح ملف PDF وتحاول تحديد سطر بالماوس، فلا يحدث شيء. البحث داخل الملف لا يجد كلمة تراها أمامك بوضوح. غالبًا المشكلة ليست في قارئ PDF؛ الصفحة نفسها قد تكون صورة ممسوحة ضوئيًا بلا طبقة نص. هنا يأتي دور OCR.
يحتوي عناصر نصية يمكن للقارئ تحديدها والبحث فيها ونسخها، بحسب بنية الملف والصلاحيات.
قد يحتوي كل صفحة كصورة فقط. أنت ترى الكلمات بعينك، لكن البرنامج لا يملك نصًا قابلًا للبحث.
كيف تعرف نوع PDF قبل تشغيل OCR؟
المسح الضوئي لا يعني تلقائيًا وجود نص
Adobe توضح أن مسح مستند ورقي إلى PDF قد ينتج ملفًا يحتوي image data فقط، وليس نصًا قابلًا للبحث. وظيفة OCR تتعرف على الحروف داخل الصورة وتضيف طبقة نص يمكن تحديدها والبحث فيها. [المصدر: Adobe Acrobat]
هذه نقطة بسيطة لكنها تغيّر طريقة التعامل مع الملف. عدد الصفحات والامتداد PDF لا يخبرانك وحدهما هل المحتوى نصي أم صور ممسوحة.
كيف تكتشف الفرق بسرعة؟
إذا استطعت سحب المؤشر فوق الحروف وتحديدها كنص، فهناك على الأقل محتوى نصي في ذلك الموضع.
ابحث عن كلمة واضحة من الصفحة. عدم العثور عليها رغم ظهورها قد يعني غياب طبقة النص أو ضعفها.
النص المصور يكشف أحيانًا حدود البكسلات، بينما النص الحقيقي يُرسم بواسطة القارئ من عناصر النص والخطوط.
ما الذي يفعله OCR وما حدوده؟
ما الذي يفعله OCR فعلًا؟
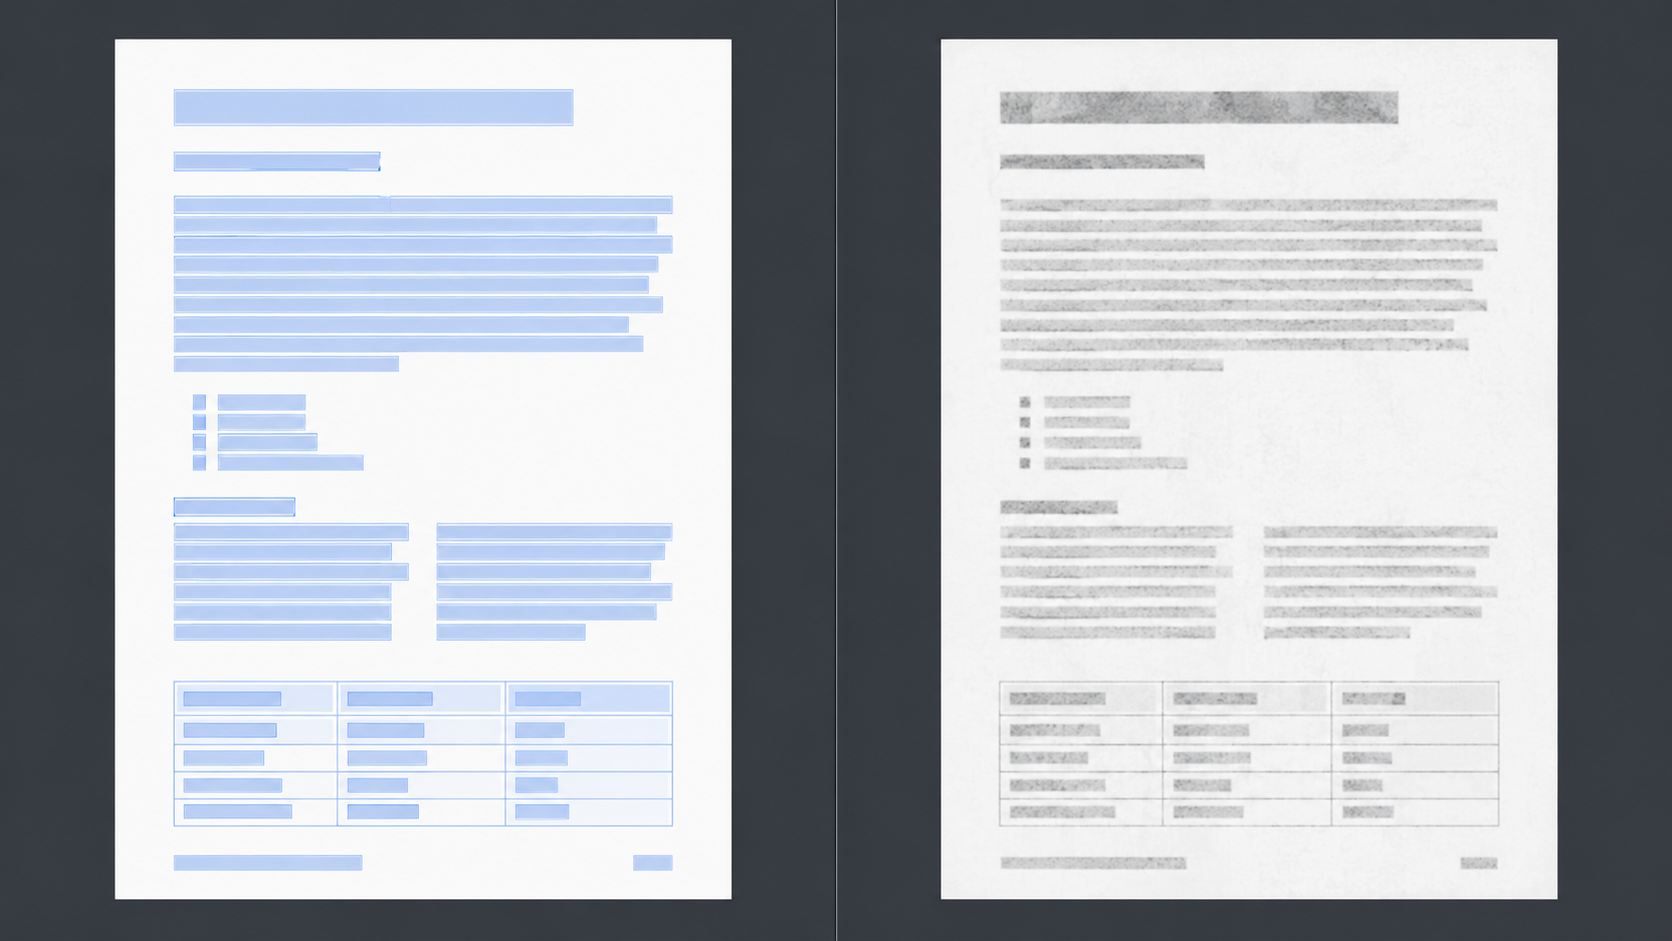
OCR اختصار Optical Character Recognition. العملية تحلل الصورة وتحاول تحويل الأشكال التي تبدو كحروف وكلمات إلى نص رقمي. بعد نجاحها تستطيع التطبيقات بناء طبقة نص فوق الصورة الأصلية أو إنتاج مستند قابل للبحث.
- الصفحة تبدأ كصورة ممسوحة.
- النظام يحدد مناطق النص والأسطر والحروف.
- تُستخدم اللغة والإعدادات للتعرف على المحارف.
- يُنشأ نص قابل للبحث والتحديد فوق الصفحة أو داخل بنيتها.
- تحتاج النتيجة مراجعة، خصوصًا في الأسماء والأرقام والجداول.
OCR لا يعيد كتابة المستند بدقة مضمونة
Adobe نفسها توصي بمراجعة المستند بعد تشغيل OCR والتأكد من أن النص دقيق وكامل، وتصحيح الأخطاء أو إعادة التشغيل بإعدادات مناسبة إذا لزم الأمر. [المصدر: Adobe]
ما الذي يؤثر في جودة التعرف؟
وضوح المسح عامل أساسي، وكذلك التباين، ميل الصفحة، حجم الحروف، اللغة المختارة، وجود جداول وأعمدة، والخطوط غير المعتادة. المستند النظيف المطبوع أسهل عمومًا من إيصال باهت أو صورة هاتف مائلة.
اختيار لغة التعرف الصحيحة مهم للنص العربي. النظام الذي يتوقع الإنجليزية فقط لن يتعامل مع الحروف العربية بالطريقة نفسها.
هل OCR يغيّر شكل الصفحة؟
ليس بالضرورة. أحد الأساليب الشائعة هو الاحتفاظ بصورة الصفحة كما هي وإضافة طبقة نص مرتبطة بها. المستخدم يرى المسح الأصلي تقريبًا، لكنه يستطيع البحث والتحديد.
هناك أساليب أخرى تعيد بناء المحتوى أو تحاول تصحيح الصورة، لذلك النتيجة تعتمد على الأداة والإعداد المستخدم.
ليس كل ملف صعب النسخ يحتاج OCR
هل كل PDF الذي لا يسمح بالنسخ يحتاج OCR؟
لا. قد يحتوي الملف نصًا حقيقيًا لكن تكون عليه قيود أمان، أو قد تكون بنية النص غير عادية، أو يستخدم خطوطًا وترميزات تجعل النسخ سيئًا. عدم القدرة على النسخ وحده ليس تشخيصًا قاطعًا بأنه ملف ممسوح.
ماذا عن PDF الهجين؟
بعض الملفات تحتوي صفحات نصية حقيقية وصفحات أخرى ممسوحة، أو صورة صفحة مع نص OCR مخفي فوقها. لذلك الاختبار الأفضل يكون على أكثر من صفحة، لا على الصفحة الأولى فقط.
هل OCR يقلل حجم الملف؟
ليس هذا هدفه الأساسي. إضافة طبقة نص قد تزيد بيانات جديدة، بينما تحسين الصور أو ضغطها قد يقلل الحجم في عملية منفصلة. إذا كان هدفك الحجم، راجع دليل لماذا يكون PDF كبيرًا وكيف تقلل حجمه.
هل PDF نفسه يفرض أن يكون المحتوى نصًا؟
لا. معيار ISO 32000-2:2020 يحدد PDF كصيغة لتمثيل المستندات الإلكترونية، ويمكن للمستند أن يجمع أنواع محتوى مختلفة. ISO لا يفرض أن الصفحة الممسوحة يجب أن تحتوي طبقة OCR. [المصدر: ISO 32000-2:2020]
متى يكون OCR مفيدًا عمليًا؟
متى يستحق تشغيل OCR؟
حتى تستطيع البحث في العقود والفواتير والتقارير بدل فتح كل ملف يدويًا.
OCR يوفر نقطة بداية أسرع، مع مراجعة النص الناتج.
وجود النص يساعد أنظمة البحث على العثور على المحتوى داخل المستند.
وجود بنية نصية أفضل من صورة صامتة، لكن الوصول الكامل يحتاج أيضًا بنية وترتيب قراءة وعناصر مناسبة.
الجداول والأرقام تحتاج مراجعة أقوى من الفقرات العادية
OCR قد يتعرف على فقرة عربية بصورة مقبولة ثم يخطئ في جدول صغير أو رقم فاتورة أو تاريخ. السبب أن الجداول لا تتطلب التعرف على الحروف فقط؛ يجب أيضًا فهم الأعمدة والصفوف والمسافات بينها. وإذا كان المسح مائلًا أو الخلايا ضيقة، قد يختلط ترتيب القيم.
عند مراجعة مستند مالي أو إداري، لا تكتفِ بالبحث عن كلمة واحدة. افحص الأرقام الحساسة، أسماء الأشخاص، أرقام الوثائق، التواريخ، والحقول التي قد يتغير معناها بخطأ محرف واحد.
اختيار اللغة لا يغني عن جودة الصورة
تحديد العربية يساعد محرك التعرف على توقع الحروف المناسبة، لكنه لا يصلح صورة ضبابية أو صفحة مقصوصة أو نصًا صغيرًا جدًا. إذا كانت النتيجة سيئة، أعد المسح بدقة أوضح واستقامة أفضل قبل تكرار OCR مرات كثيرة على المصدر نفسه.
قبل اعتماد النسخة الجديدة
احتفظ بنسخة الأصل. بعد OCR جرّب البحث عن كلمات من أماكن مختلفة، وانسخ فقرة عربية فيها أرقام أو أسماء، وراجع الجداول والهوامش. إذا كانت الوثيقة مهمة، لا تعتمد على اختبار صفحة واحدة.
أداة PDF في تولاتي وOCR
أداة PDF الحالية في تولاتي تركز على إدارة الملفات والصفحات مثل الدمج والتقسيم والعمليات المتاحة في الصفحة. إذا كان ملفك ممسوحًا ويحتاج التعرف على النص، استخدم أداة OCR مخصصة ثم ارجع لإدارة الصفحات عند الحاجة.
هذا أوضح من الادعاء بأن كل عملية PDF تحل مشكلة النص المصور؛ OCR مجال مستقل وله متطلبات جودة ولغة ومراجعة.
ابدأ بتشخيص نوع الملف أولًا
إذا كان هدفك دمج الصفحات أو تقسيمها، استخدم أدوات PDF في تولاتي. وإذا كان الهدف جعل المسح قابلًا للبحث، شغّل OCR في أداة مخصصة ثم راجع النتيجة.
المصادر الرسمية المستخدمة
- Adobe Acrobat — Recognize text in scanned documents: الفرق بين الصورة الممسوحة والنص القابل للبحث وعملية OCR ومراجعة النتيجة.
- ISO 32000-2:2020 — PDF 2.0: المعيار الدولي الحالي لصيغة PDF.