
تنسخ الفقرة نفسها في أداتين، فتجد واحدة تقول 120 كلمة والثانية 123. أيهما مخطئة؟ ربما لا واحدة منهما. اختلاف النتيجة قد يأتي من تعريف “الكلمة” نفسه، ومن طريقة التعامل مع علامات الترقيم والتشكيل والرموز المركبة والأسطر.
ما الذي نعدّه فعلًا؟
أبسط عد للكلمات يبدأ من الفراغات
أبسط خوارزمية شائعة تقول: نظّف الفراغات، ثم افصل النص عند المسافات وأسطر النهاية، وعد الأجزاء غير الفارغة. هذه الطريقة سريعة ومفهومة، وتعمل جيدًا في نصوص عربية كثيرة للاستخدام اليومي. وإذا كان النص نفسه يحتوي تشكيلًا أو تطويلًا أو مسافات غير مرغوبة، فراجع أولًا دليل تنظيف النص العربي.
لكنها ليست تعريفًا لغويًا كاملًا للكلمة. علامات الترقيم، الشرطات، الرموز، الروابط، الإيموجي، وبعض اللغات التي لا تعتمد المسافات بين الكلمات قد تجعل النتيجة مختلفة عن أداة تستخدم قواعد Unicode أكثر تقدمًا.
العد بالفراغات يعطي أربع وحدات واضحة هنا. المثال يصبح أصعب عندما تدخل العلامات أو الكلمات المركبة أو النص المختلط.
Unicode لا يعرّف الحرف كما نراه دائمًا بعيننا
Unicode Standard Annex #29 يفرّق بين code points وبين ما يسميه extended grapheme clusters، أي الوحدات التي يراها المستخدم غالبًا كحرف واحد. هذه الفكرة ضرورية لأن “الحرف الظاهر” قد يتكون من أكثر من code point. [المصدر: Unicode UAX #29]
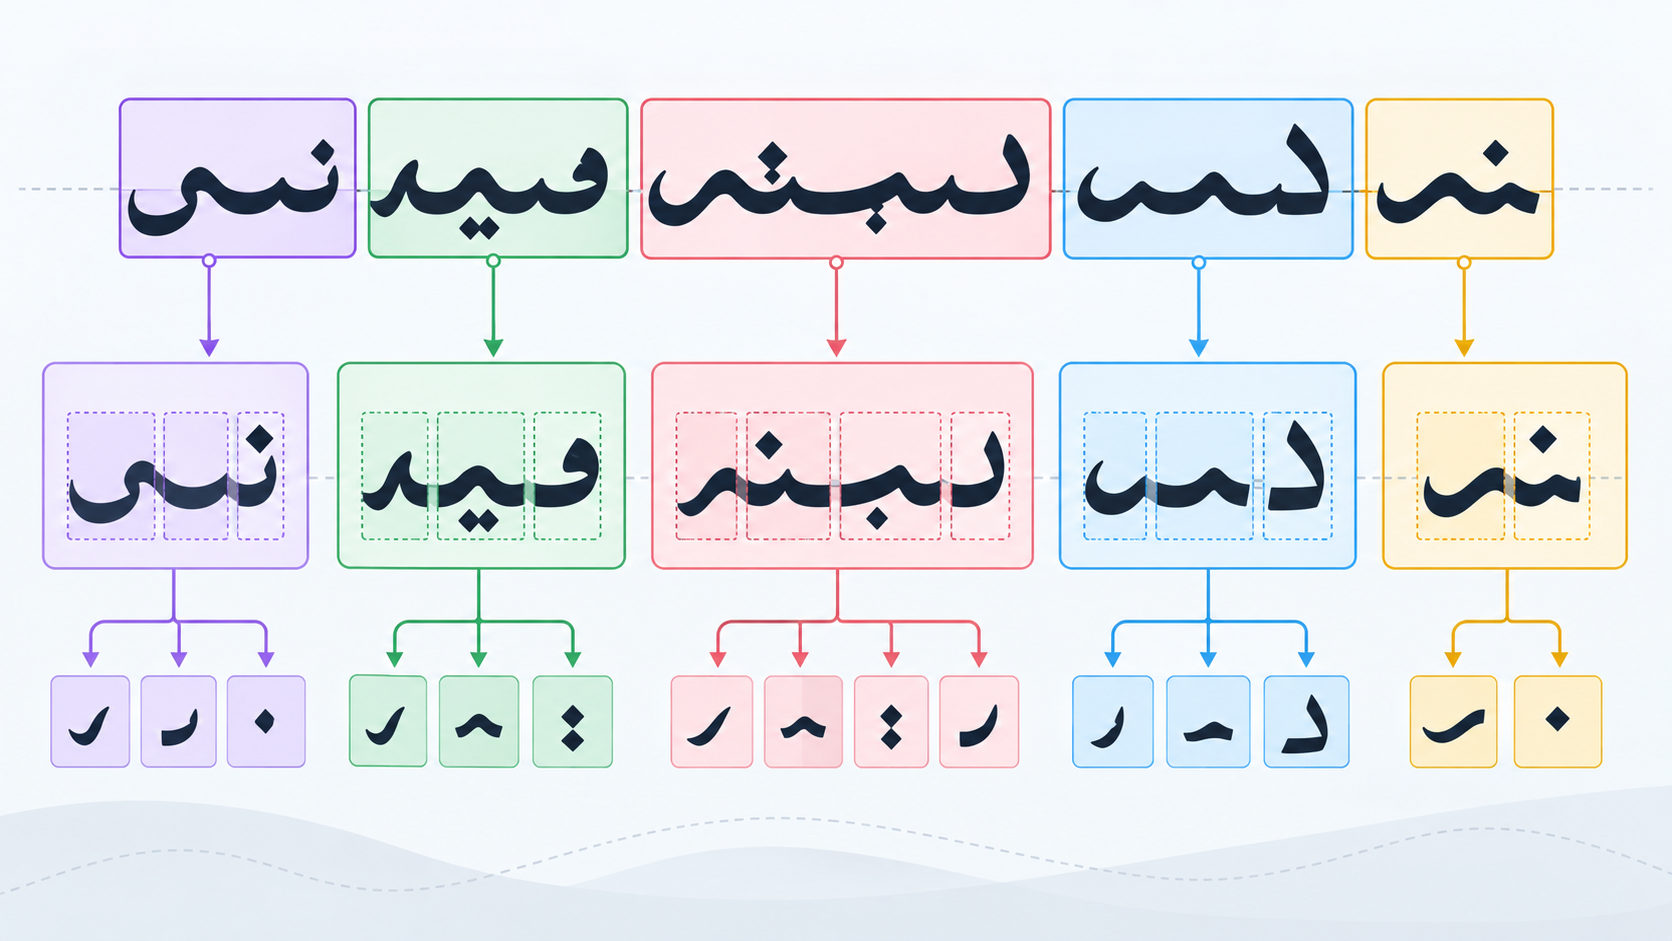
في العربية، الحرف الأساسي مع حركة قد يكون أكثر من code point، لكنه يظهر كوحدة كتابية واحدة للقارئ. إذا كانت أداة تحسب code units أو code points، وأداة أخرى تحسب grapheme clusters، فمن الطبيعي أن تختلف الأرقام.
التشكيل مثال عربي واضح
كلمة عربية مشكولة قد تحتوي حروفًا أساسية وعلامات combining marks. من منظور المستخدم هي الكلمة نفسها مع نطق موضح، لكن من منظور عد المحارف الخام هناك محارف إضافية.
لهذا قد يعطي “عدد الحروف” رقمًا مختلفًا حسب السؤال: هل نعد code units؟ code points؟ أم الأحرف الإدراكية grapheme clusters؟ هذه ليست فروقًا تجميلية، بل تعريفات مختلفة.
ما هي Word Boundaries في Unicode؟
UAX #29 يحدد قواعد افتراضية لتقسيم النص إلى حدود للكلمات والجمل والأحرف الإدراكية. ويؤكد أن حدود الكلمات ليست مجرد “مسافة أو علامة ترقيم”، لأن اللغات وأنماط الكتابة مختلفة، وبعض الحالات تحتاج قواعد خاصة. citeturn506590search0
هذا يفسر لماذا يمكن لمحرر متقدم أن يتعامل مع نص مختلط أو أرقام أو علامات بطريقة أذكى من عداد يعتمد فقط على split عند الفراغ.
Intl.Segmenter مثال على عد أكثر حساسية للغة
مواصفة ECMA-402 الخاصة بالتدويل في JavaScript تتضمن Intl.Segmenter، وتسمح بالتقسيم إلى grapheme أو word أو sentence حسب locale. وعندما تكون granularity هي word، تعيد النتيجة أيضًا مؤشرًا يوضح هل الجزء “word-like”. [المصدر: ECMA-402]
هذا لا يعني أن كل أداة تستخدم Intl.Segmenter، ولا أن هناك رقمًا عالميًا وحيدًا لكل نص. يعني فقط أن المطور يستطيع اختيار مستوى أكثر تطورًا من العد بحسب احتياج المنتج.
لماذا تختلف النتائج بين الأدوات؟
لماذا قد تختلف نتيجة الكلمات بين أداتين؟
أداة قد تعتبر النص الملتصق بفاصلة كلمة واحدة، وأخرى تطبق حدودًا لغوية منفصلة.
قد تُحسب كوحدة واحدة أو عدة وحدات بحسب الخوارزمية.
وجود شرطة أو apostrophe قد يغيّر segmentation في بعض اللغات.
العربية مع الإنجليزية والأرقام والإيموجي تزيد اختلاف الحالات الطرفية.
وماذا عن عد الأسطر؟
حتى الأسطر ليست دائمًا بالبساطة نفسها. نهاية السطر قد تمثلها LF أو CRLF حسب النظام. الأداة الجيدة تتعامل مع هذه الاختلافات بدل عد كل محرف نهاية سطر كأنه سطر إضافي.
كما أن السطر المرئي الذي يلتف تلقائيًا داخل مربع النص ليس بالضرورة “سطرًا جديدًا” في البيانات. إذا كتبت جملة طويلة والتفت بصريًا إلى ثلاثة أسطر، فقد تبقى في النص سطرًا واحدًا بلا أي newline.
كيف تحسب أداة النصوص في تولاتي؟
الأداة الحالية في تولاتي تستخدم عدًا عمليًا مباشرًا مناسبًا للمقالات والنماذج اليومية: الكلمات تُستنتج من الأجزاء المفصولة بالمسافات وفواصل الأسطر، مع إحصاءات للحروف مع المسافات وبدونها والأسطر.
هذا متعمد لأنه سريع ومفهوم للمستخدم. لكنه ليس محللًا لغويًا كاملًا ولا يدعي تطبيق كل قواعد Unicode word segmentation. لذلك قد ترى فرقًا بينها وبين محرر يستخدم خوارزمية locale-sensitive.
أي طريقة عد تناسب استخدامك؟
متى يكفي العداد البسيط؟
في كتابة مقال، تقدير طول فقرة، نموذج داخلي، قائمة كلمات، أو مراجعة سريعة لمحتوى عربي عادي، العد المبني على الفراغات غالبًا مناسب جدًا. الفارق المحتمل في الحالات الطرفية لا يغير المهمة.
ومتى تحتاج تقسيمًا لغويًا أدق؟
في محرر نصوص احترافي، محرك بحث، تطبيق تعليمي، معالجة لغوية، أو منتج يدعم عدة لغات بأنظمة كتابة مختلفة، من الأفضل التفكير في Unicode segmentation وأدوات مثل Intl.Segmenter أو مكتبات متخصصة.
ثلاث وحدات مختلفة قد تُسمّى كلها “حرفًا”
في البرمجة هناك فرق بين UTF-16 code unit وUnicode code point وgrapheme cluster. مواصفة ECMAScript تعرف String كسلسلة من قيم UTF-16 ذات 16 بت، وتوضح أن طول السلسلة هو عدد هذه الوحدات، لا عدد “الأحرف المرئية” بالضرورة. [المصدر: ECMAScript 2026]
هذا يظهر بوضوح مع بعض الإيموجي والمحارف خارج Basic Multilingual Plane: الرمز الواحد قد يحتاج زوجًا من UTF-16 code units. وإذا استخدمت string.length مباشرة فقد تحصل على 2 رغم أن المستخدم يرى رمزًا واحدًا.
ثم تأتي grapheme clusters، وهي أقرب لما يراه المستخدم كحرف واحد. حرف عربي مع علامات مركبة أو إيموجي مكوّن من عدة code points قد يظهر كوحدة بصرية واحدة رغم أن البنية الداخلية أطول. لهذا عندما تقول أداة “عدد الحروف” يجب أن تعرف أي مستوى تعدّه بالفعل.
لماذا هذا مهم في النص العربي تحديدًا؟
لأن التشكيل والرموز المركبة تجعل الفرق بين “ما تراه” و“ما هو مخزن” أوضح. كلمة مشكولة بالكامل قد تبدو بطول قريب من الكلمة غير المشكولة، بينما عد code points يعطي رقمًا أكبر. أما عد grapheme clusters فقد يطابق إدراك المستخدم أكثر.
عدد الحروف مع المسافات وبدونها
هاتان القيمتان تخدمان احتياجات مختلفة. بعض المنصات تحسب المسافات ضمن الحد الأقصى، وأخرى تتحدث عن “حروف” لكن تطبيقها الداخلي قد يختلف. لا تحذف المسافات من النص نفسه فقط لمطابقة رقم؛ استخدم العداد المطلوب ثم اختبر في الوجهة النهائية.
قاعدة عملية عند وجود اختلاف
إذا أعطتك أداتان رقمين مختلفين، لا تبدأ بسؤال “من المخطئ؟”. اسأل أولًا: ما تعريف الكلمة أو الحرف في كل أداة؟ ما الذي سأستخدم الرقم لأجله؟ وأي منصة هي المرجع النهائي؟
عدّ النص ونظفه من مكان واحد
أدوات النصوص في تولاتي تعرض الكلمات والحروف والأسطر أثناء الكتابة، وتتيح تنظيف المسافات والتشكيل والتكرارات. استخدم الإحصاء كأداة عملية، مع معرفة طريقة العد المستخدمة.
المصادر الرسمية المستخدمة
- Unicode Standard Annex #29 — Unicode Text Segmentation: المرجع الرسمي لحدود grapheme والكلمات والجمل.
- ECMA-402 — Intl.Segmenter: التقسيم الحساس للغة إلى grapheme وword وsentence في JavaScript.
- ECMAScript 2026 — String Type: تعريف طول String بوحدات UTF-16 وسبب اختلافه أحيانًا عن عدد الأحرف المرئية.